Управление оперативной памятью
Задачи:
- Контроль состояния каждой единицы памяти (свободна/распределена)
- Стратегия распределения памяти (кому и когда сколько памяти выделять)
- Выделение памяти (выбор конкретной области, которая должна быть выделена)
- Стратегия освобождения памяти (процесс освобождает - ОС “забирает” окончательно или временно. В случае нехватки памяти решить, какой процесс можно выгрузить)
Стратегии и методы управления Mark
1. Одиночное непрерывное распределение
Делится на две непрерывные области: используемая и неиспользуемая.
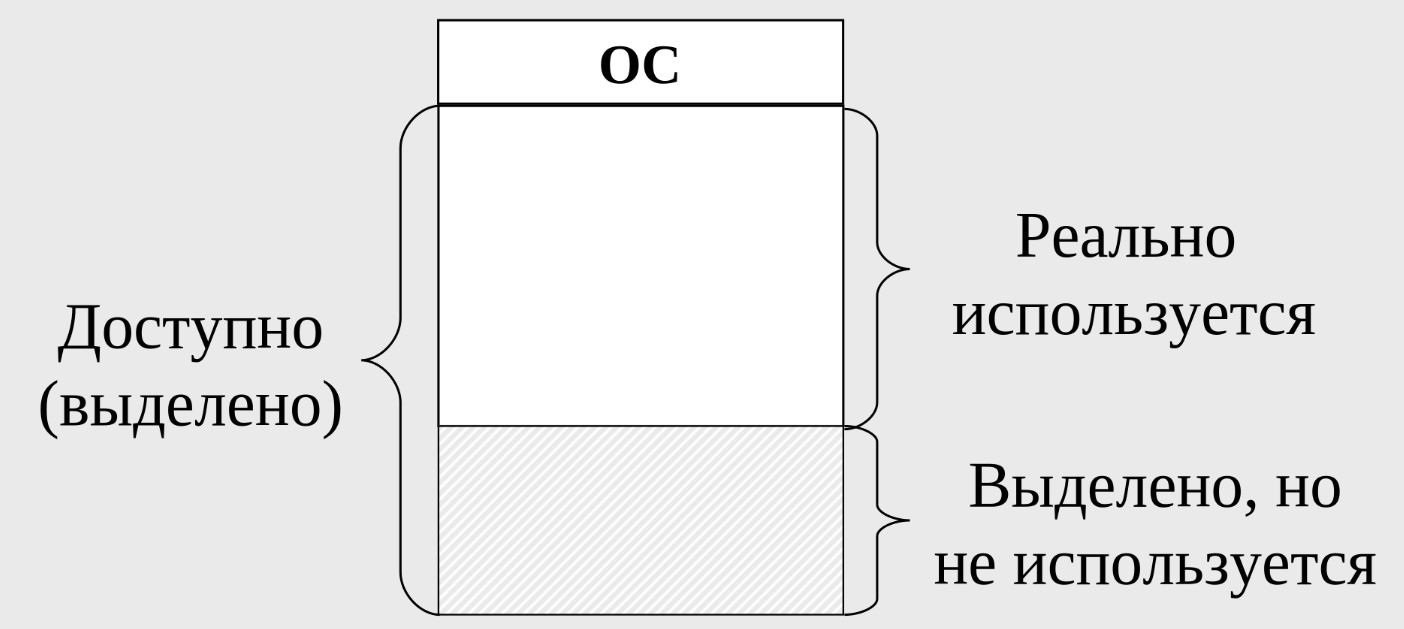
Аппаратная поддержка:
- Регистр “водораздела” (не обязательно)
- Режим ОС/режим пользователя
Плюсы:
- Очевидные алгоритмы
- Простота
Недостатки:
- Часть памяти не используется
- …
2. Разделение неперемещаемыми разделами
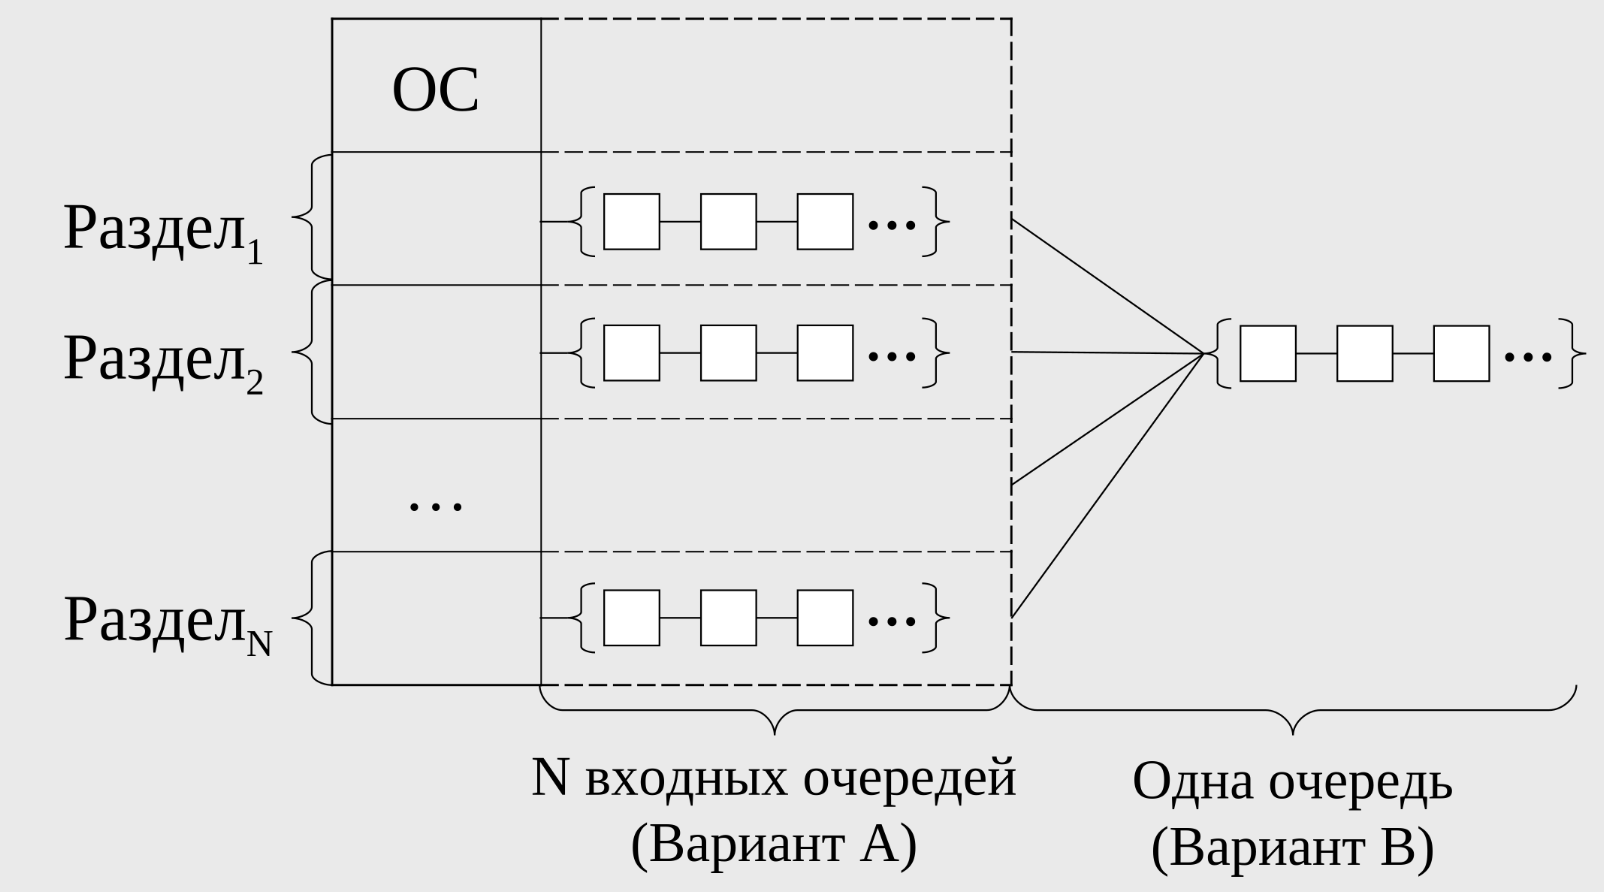
Разделы фиксированного размера и не изменяются в процессе работы. В каждый раздел можно поместить один из обрабатываемых процессов.
Плюсы:
- Простое средство организации мультипрограммирования
- Простые средства аппаратной поддержки
- Простые алгоритмы
Недостатки: - Фрагментация (будет простой части памяти. Процессы не будут попадать точка в точку по размеру)
- Ограничение размерами физической памяти. (нет swap)
- Весь процесс размещается в памяти. (продолжительное время может выполняться малая часть загруженной программы)
А. N входных очередей
Очереди: сформированный процесс попадает в одну из очередей.
Аппаратная поддержка:
- Наличие режима опреационной системы. (нужен для того, чтобы одна программа не испортила жизнь другой программе. Вытекает из мультрипроцессности)
- Регистры границ (аппарат защиты памяти, который может быть реализован как два специальных регистра: начало и конец раздела исполняемой программы.)
Неэффективно:
- При исчерпании очередей некоторых разделов и простое других получается деградация.
Б. Одна очередь
Реализации:
- Для нового процесса ищем первый попавшийся свободный раздел.
- По освобождении места большим процесом, место может занять маленький. => Ещё один большой процесс туда уже не загрузишь.
- В каждом разделе один процесс.
- Ищем процесс максимального размера, который может поместиться в освободившийся раздел.
- В очереди есть маленькие и большие процессы. Пироритет будет отдаваться большим и малые могут долго висеть.
- Добавляем каждому процессу счётчик дискриминации, равный k. С каждым обходом процессов k = k - 1.
- Если k = 0, обход процесса невозможен и он идёт на исполнение.
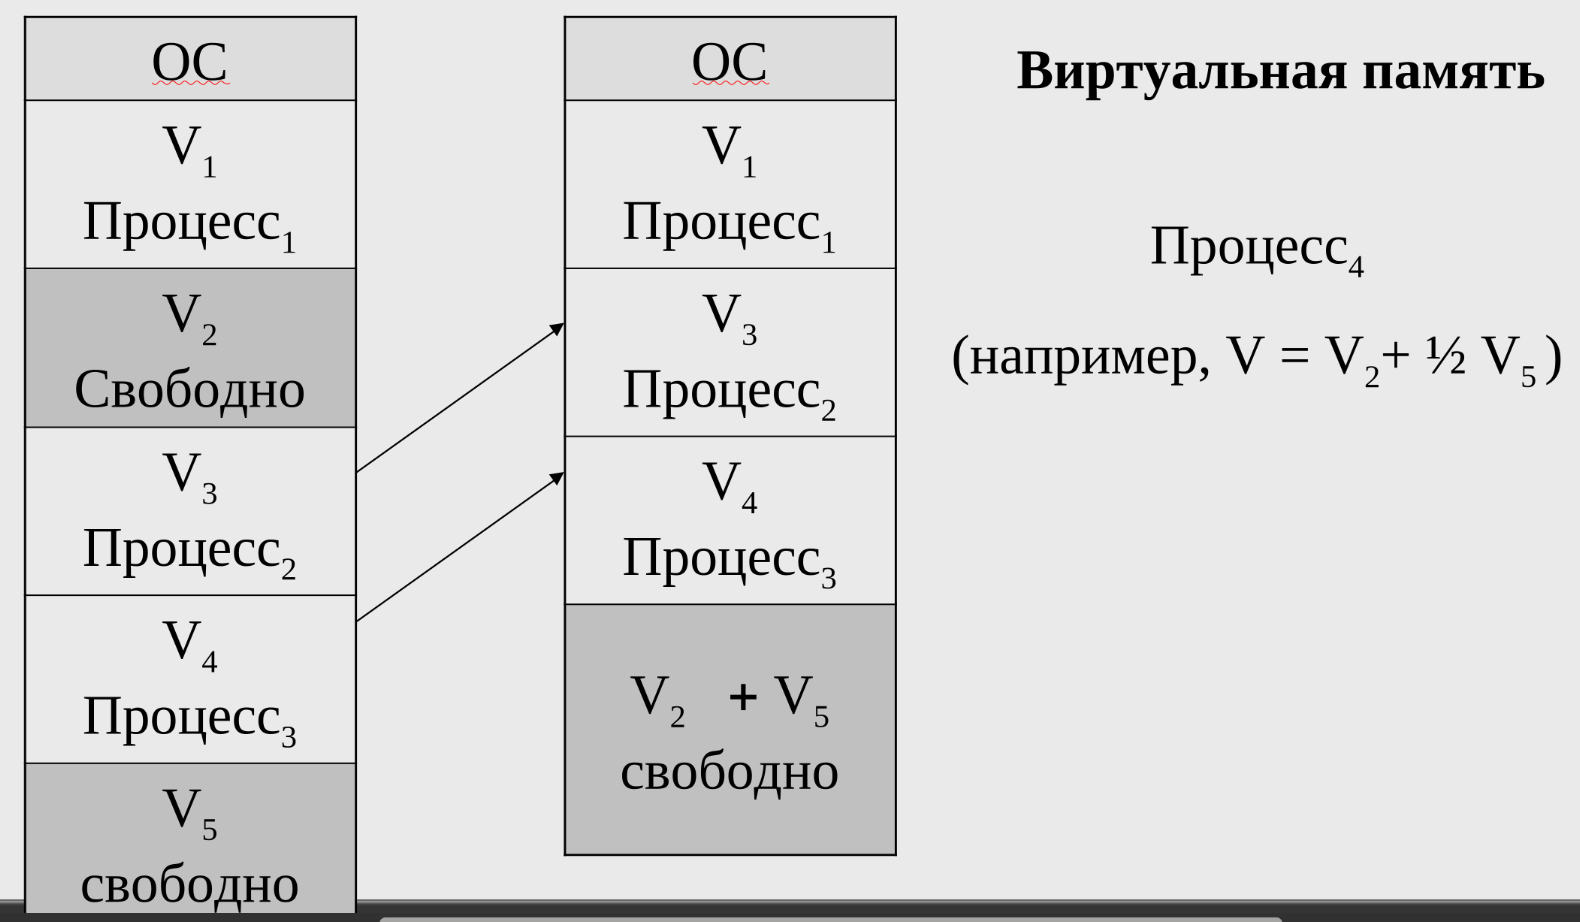
3. Перемещаемые разделы
Первая модель виртуальной реализации памяти.
Аппаратная поддержка:
- Регистры границ + регистр базы
- Аппарат защиты памяти
Плюсы:
- Ликвидация фрагментации
- Очевидные алгоритмы
Недостатки:
- Ограничение размером физической памяти
- Затраты на перекомпоновку
4. Страничная организация Mark
Инструмент виртуальной реализации. Основная идея - делим виртуальную и физическую память на страницы одинакового размера - .
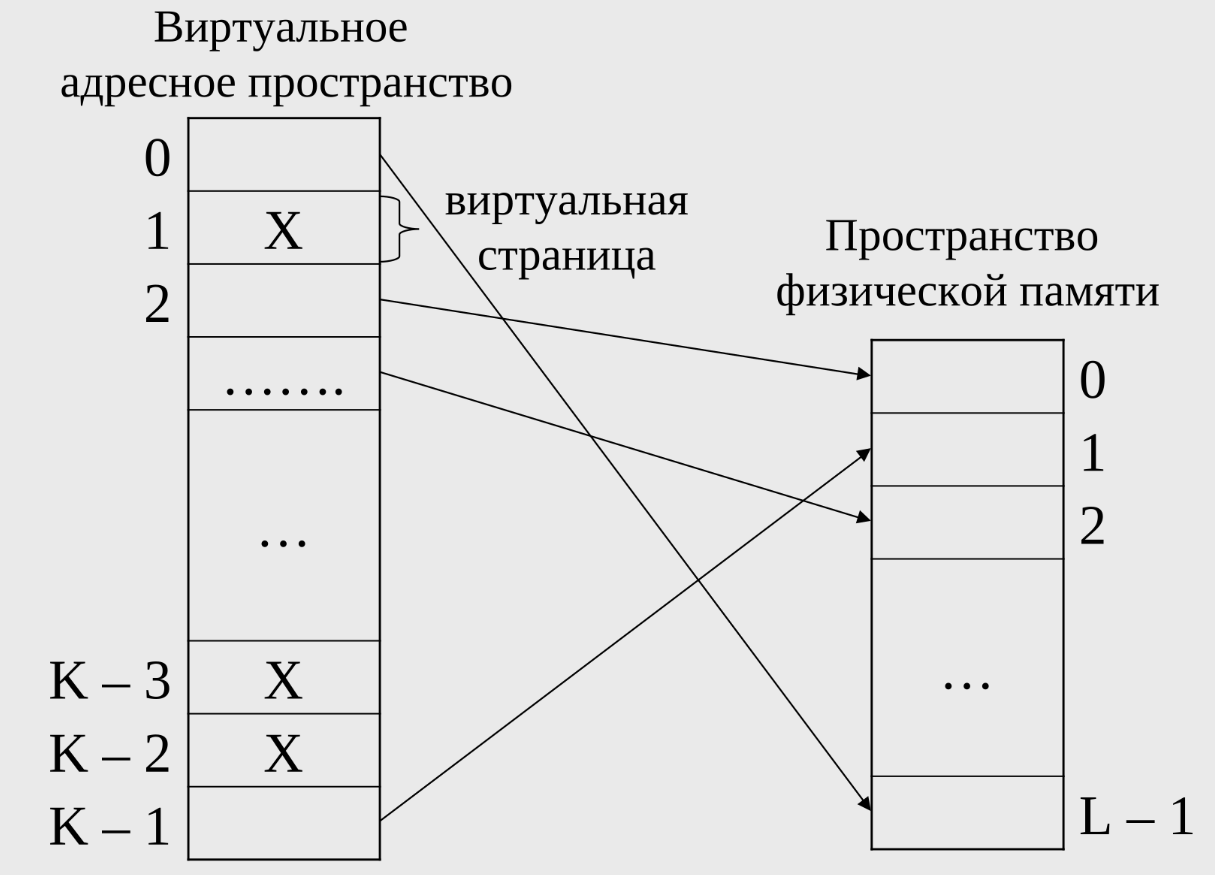
Виртуальное адресное пространство характеризуется процессом.
Физическое адресное пространство характеризуется аппаратурой.
Объём:
- Количество физических страниц ограничено физической памятью.
- Количество ограничено системой адресации машины (размер регистра, ограничивающего память и размер поля адреса).
- Соотношение и может быть любым.
Таблица страниц - отображение номеров виртуальных страниц на номера физических. Находится в оперативной памяти.
При обращении по виртуальному адресу страницы мы заменяем виртуальный адрес физическим и работаем.
Недостатки:
- Размер таблиицы страниц много больше размеров регистров процессора.
- Скорость отобаржения может значительно замедлять работу.
Аппаратная поддержка:
- Полностью аппаратная таблица страниц. (необходима высокая скорость отображения).
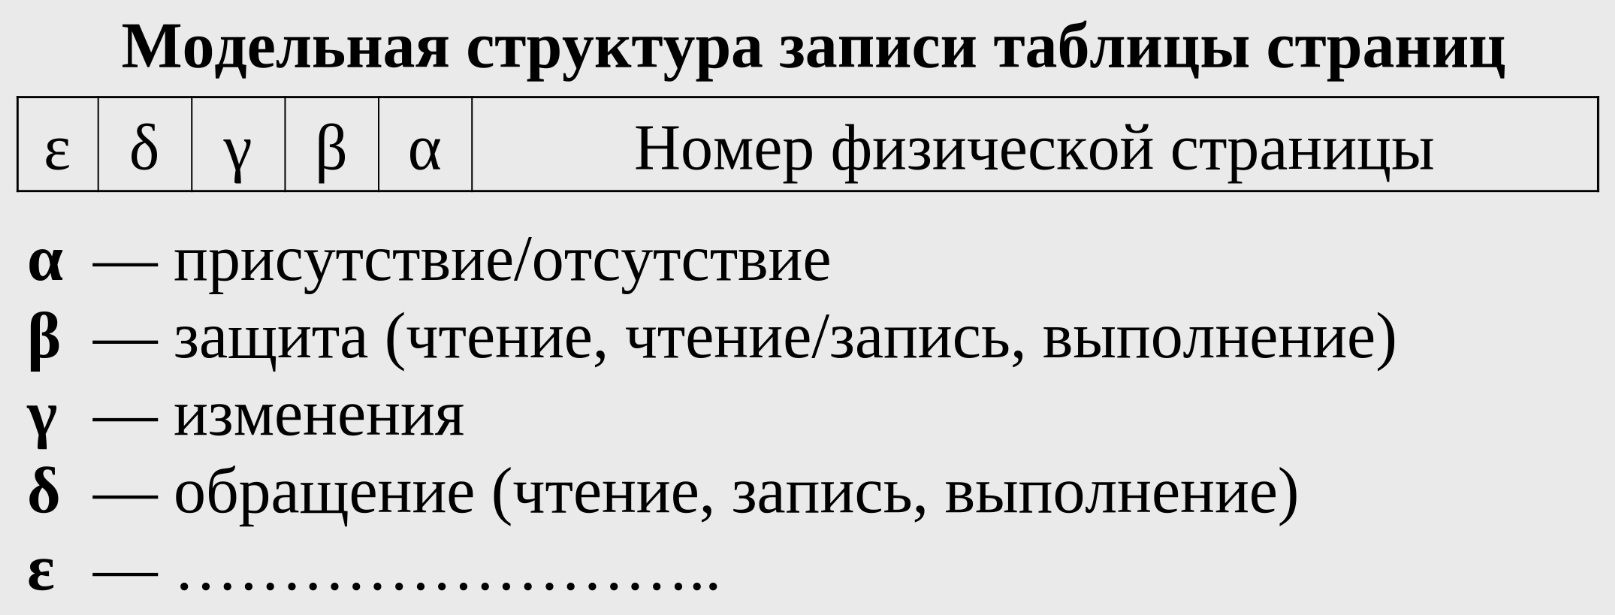 Работа с битом присутствия.
5. TLB (Translation Lookaside Buffer)
Таблица/буфер быстрого преобразования. Идея: сделать аналогию кэша, но для таблицы страниц.

В процессоре есть небольшая таблица из двух колонок (+ служебные поля в духе интенсивности использования).
В процессоре организована аппаратная поддрежка параллельного поиска в TLB.
Если нашли в TLB - попадание.
Если не нашли - обращаемся в таблицу страниц, получаем адрес и корректируем TLB.
Ускорение происходит за счёт свойства локализации.
Решаем проблемы:
- Оптимизируем доступ к страницам.
Иерархическая организация таблицы страниц.
Проблема - размер таблицы страниц.
Он ограничен в современных реалиях.
Если перегружать таблицу по ситуации, накладные расходы будут огромными.
Решение - использовать многоуровневые таблицы страниц. ()
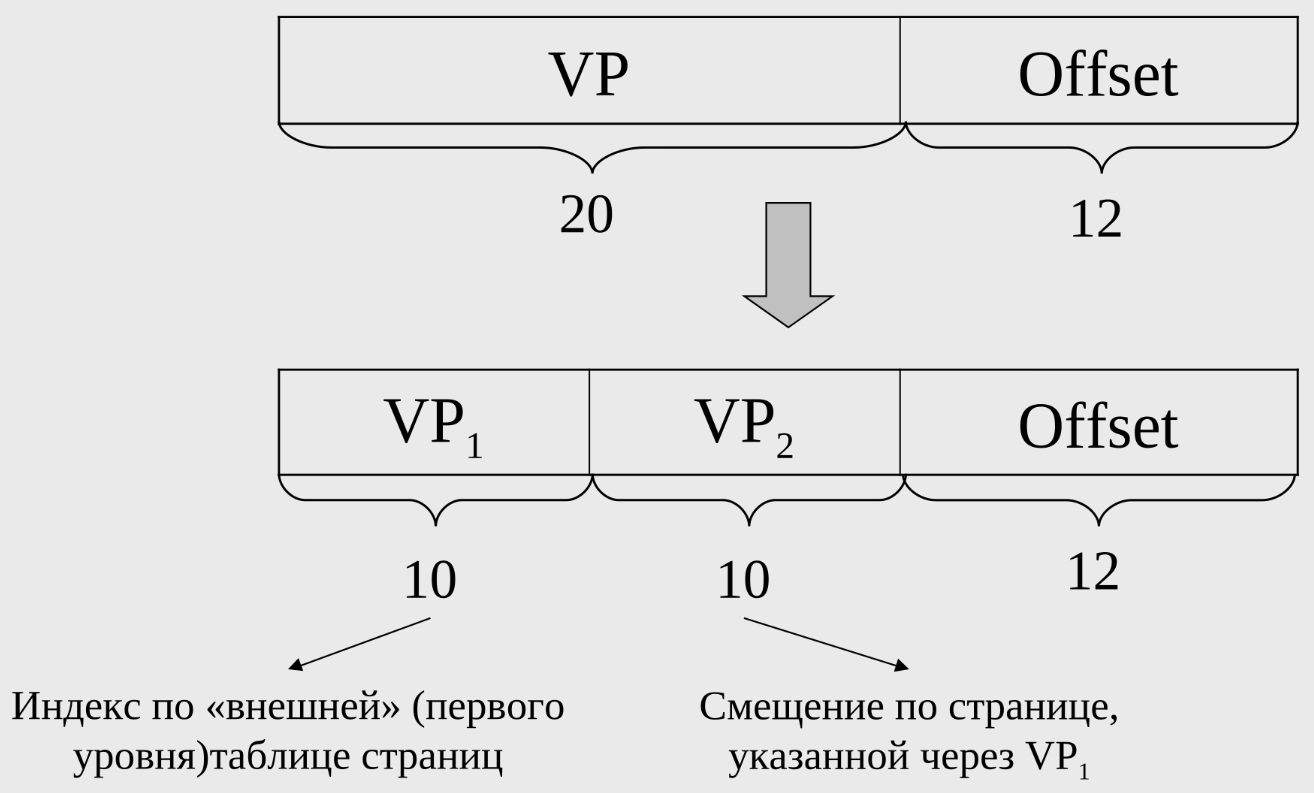
- - адрес начала таблицы второго уровня.
- - смещение относительно начала таблицы второго уровня.
- Offset - смещение внутри страницы.
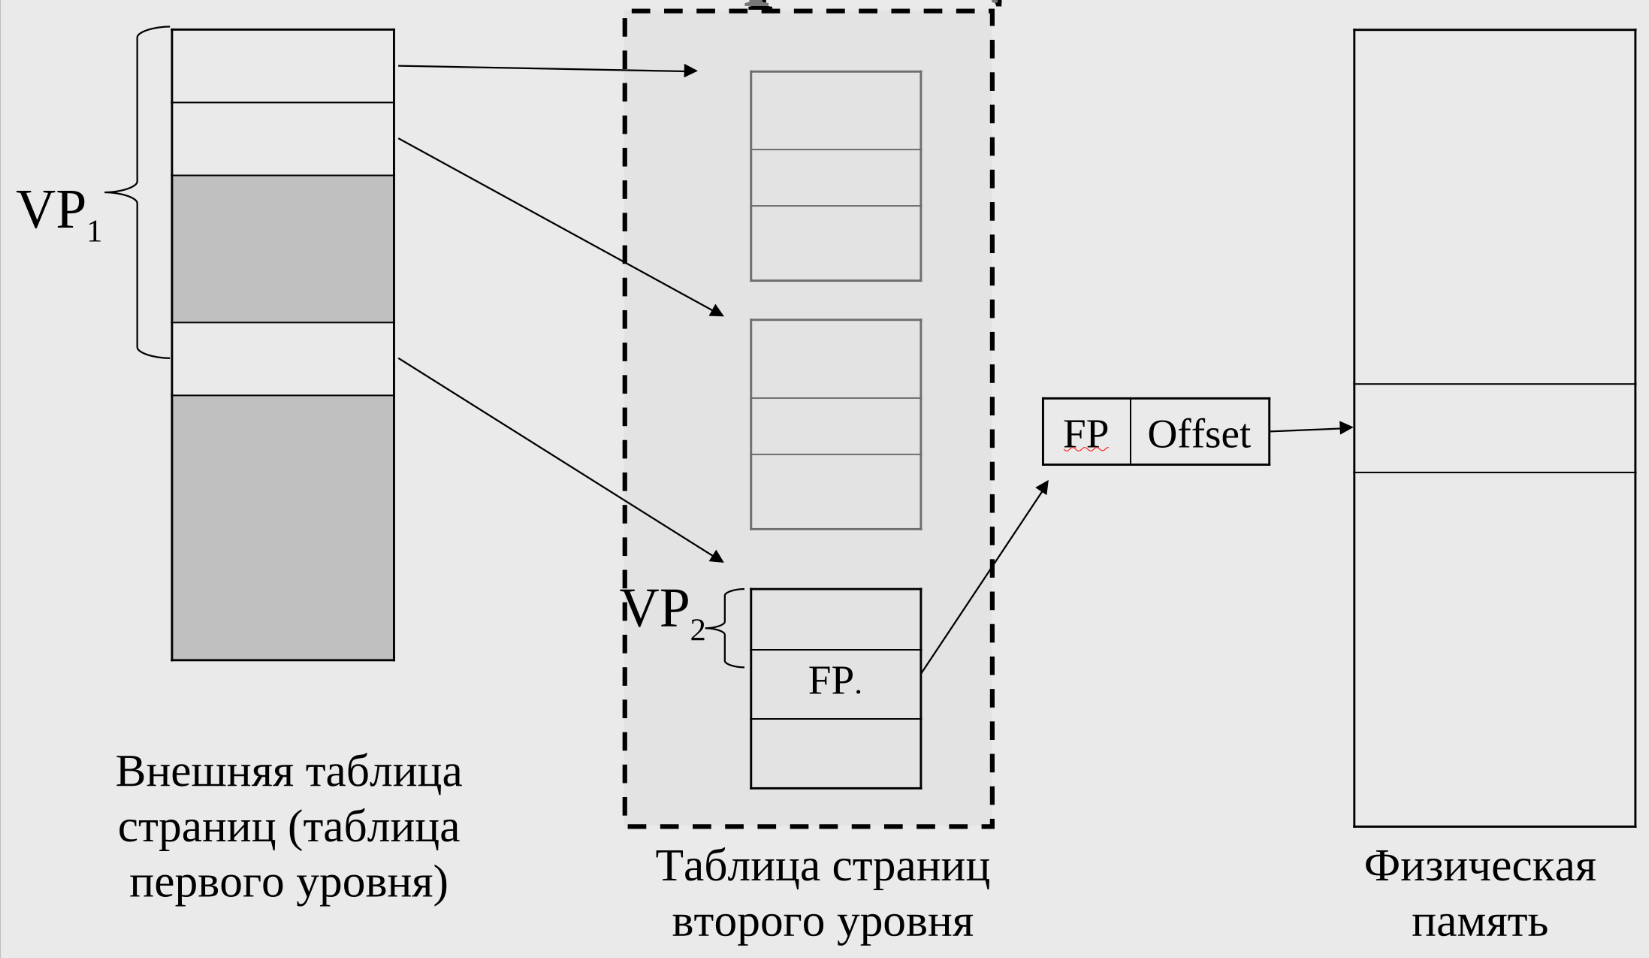
- С помощью внешней таблицы страниц мы находим адрес в одной из таблиц второго уровня.
- В таблице второго уровня мы получаем отображение виртуального адреса в физический.
Количество таблиц второго уровня потенциально может быть настройкой системы.
Количество уровней также может быть больше 2х
Таким образом:
- Увеличили размер таблицы страниц.
- Жертвуем скоростью (две таблицы держать дороже), но это частично нивелируется кэшем L1.
6. Сегментная организация памяти
- Виртуальное адресное пространство процесса представляется в виде совокупности сегментов.
- Каждый сегмент имеет свою Виртуальную адресацию (от 0 до N - 1)
- Виртуальный адрес: <номер_сегмента, смещение_по_сегменту>
Основное отличие от страничной организации - не фиксированный размер сегментов. (появилась до страничной памяти, к слову)
Аппаратная поддрежка:
- Аппаратная таблица сегментов в процессоре (может быть программной. Работает благодаря кэшу)
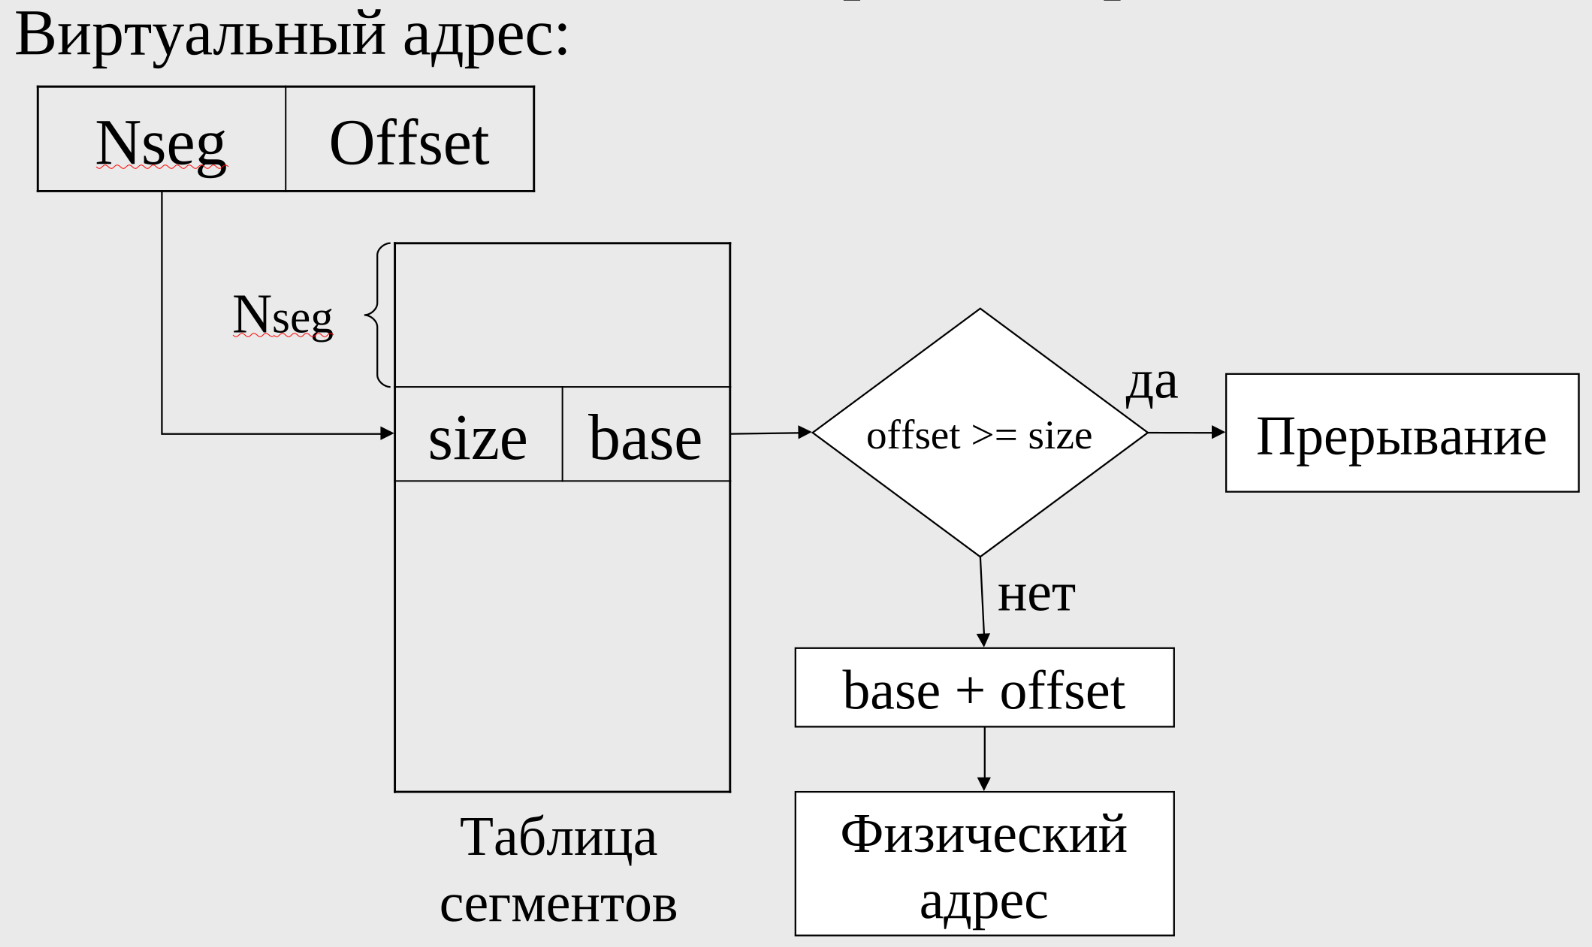
- Номер семента, сдвиг по сегменту
- Размер и базовый адрес
- Если смещение больше размера, -> прерывание.
- Иначе добавляем к базовому адресу сдвиг и получаем физический адрес.
Плюсы:
- Простейшая организация.
- Таблица сегментов аппаратно реализуемая.
- Таблица небольшая (накладные расходы минимальные).
Минусы:
- Сегменты непрерывны (весь сегмент должен быть в памяти)
- Подкачка (swap) происходит для всего сегмента сразу.
7. Сегментно-страничная память
Соместим два подхода. Нарежем сегмент на страничную память. Современные процессоры так и работают.
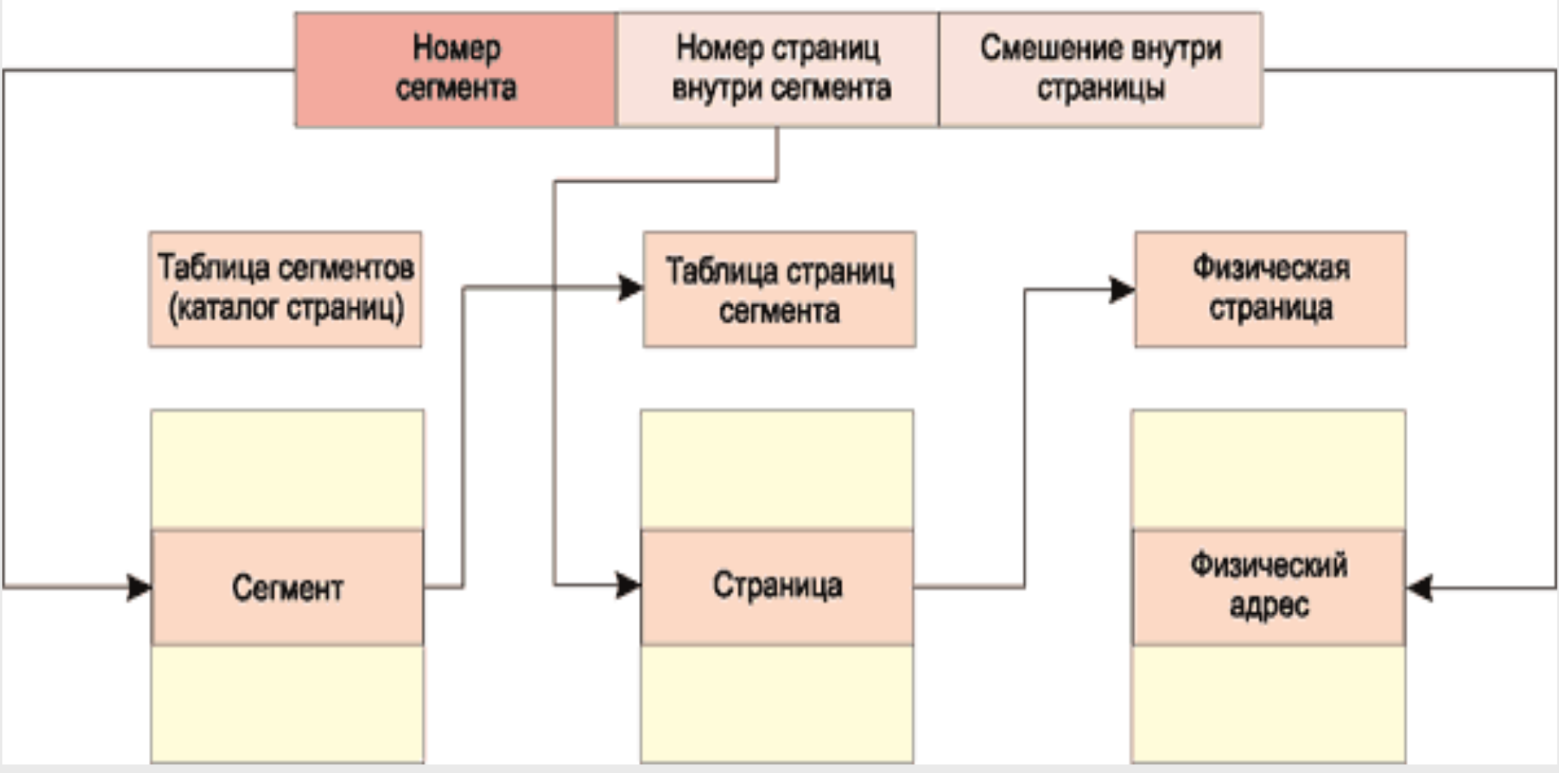
Внутри одной архитектуры страницы фиксированного размера. Даже если они находятся в разных сегментах.
Как получается физический адрес?
- Сегмент
- Страница в сегменте
- Физизческий адрес из страницы
Аппаратная составляющая:
- Таблица сегментов
Модельный пример (intel): Mark
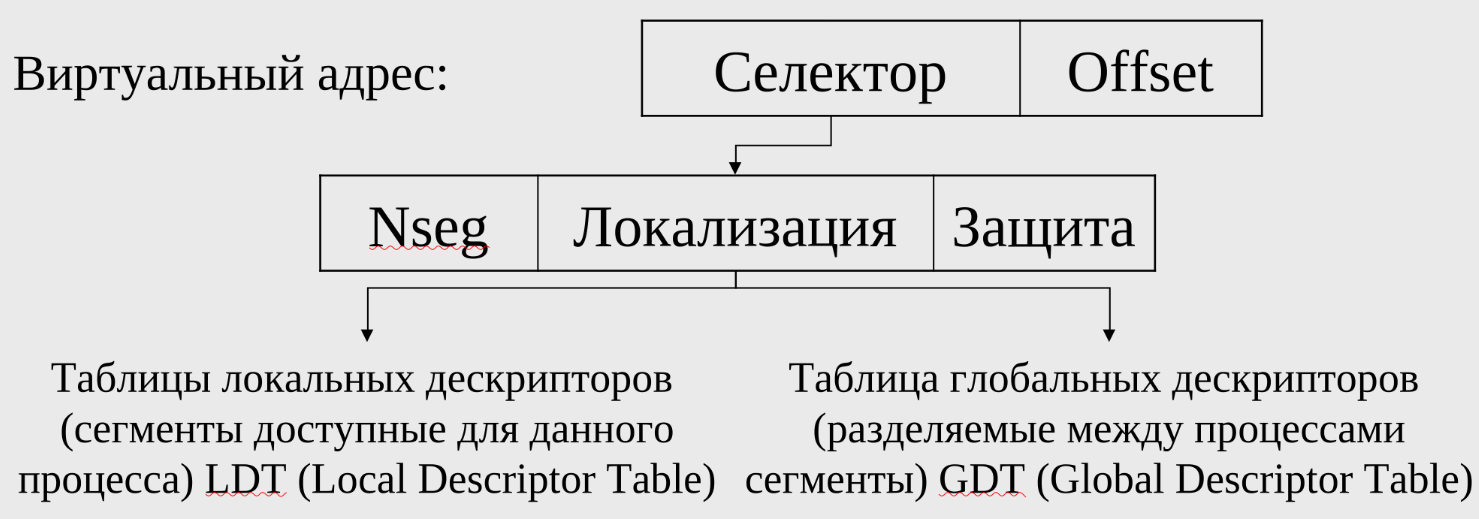
LDT и GDT - полная информация о сегменте (адрес базы, размер и т.д.)
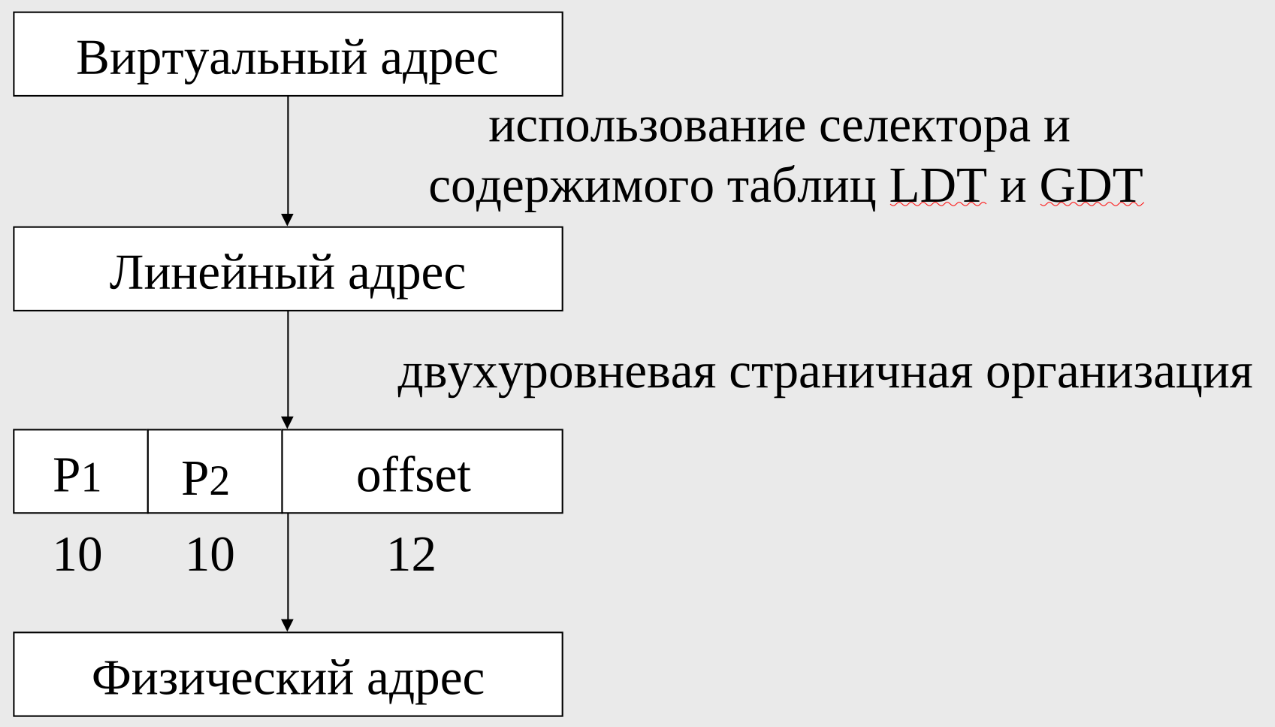
- Используется две таблицы.
Other inf Mark
Можно использовать хэш-таблицу (функция расстановки):
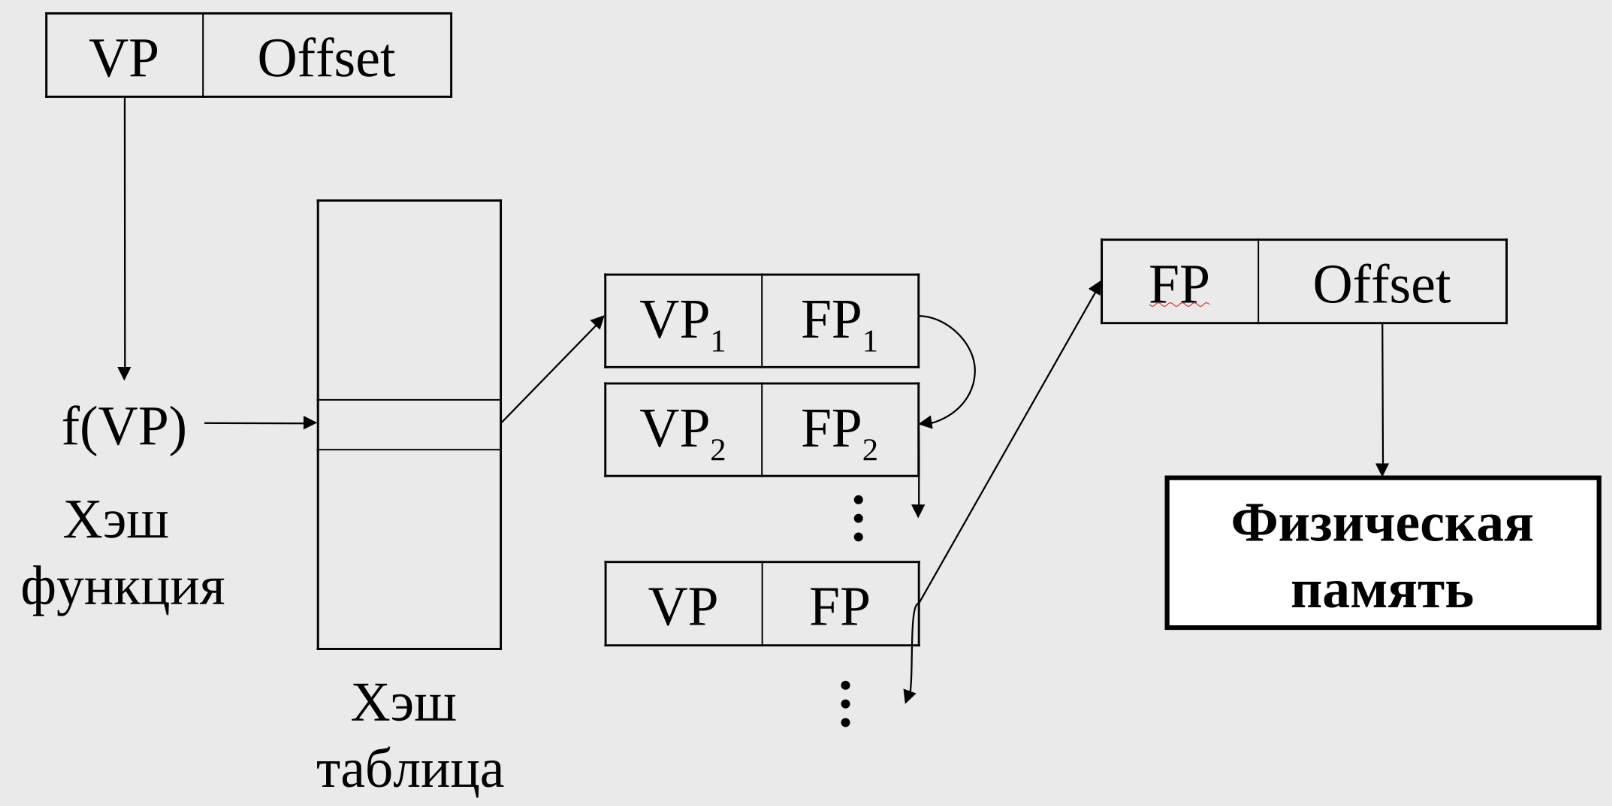
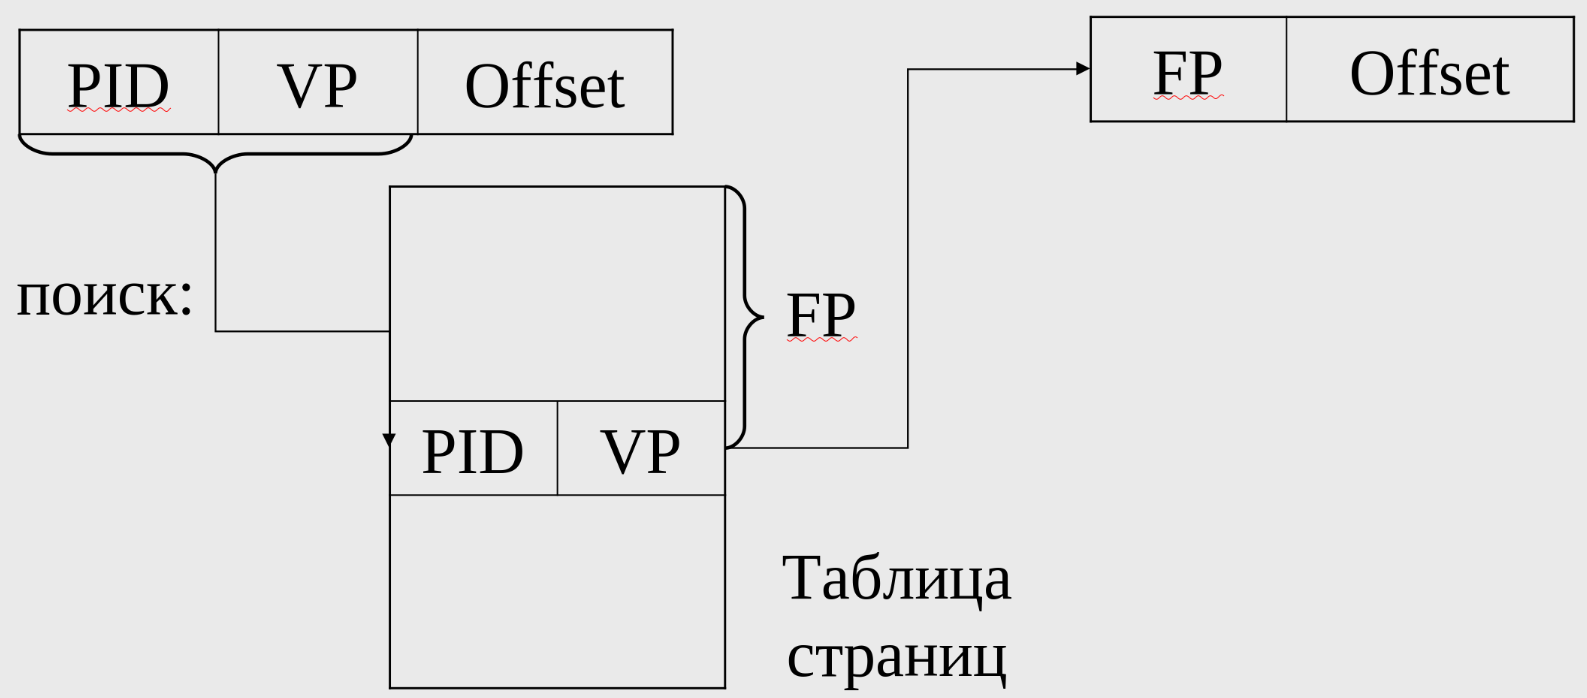
Ещё одна структура - инвертированные таблицы страниц:
Здесь мы также храним PID процесса. Размер такой таблицы равен количеству подключённой физической памяти.Плюсы: таблица одна. Нет необходимости перегружать таблицу.
Недостатки: поиск по таблице (решается hash-map)
Свопинг/Подкачка Mark
Таблица страниц (модельная):
- Количество строк таблицы - предельное количество виртуальных страниц.
- Содежимое строки таблицы - физический адрес, соответствующий виртуальный адрес, служебные биты.
“Расширенная” копия таблицы страниц:
1.
При необходимости смены текущего исполняемого процесса на новый
При обращении к отсутствующему в таблице адресу (persistent bit = 0), происходит обращение к swap.
Если программу приостановили и выгрузили из ОП в своп, в первую очередь в ОП будут возвращены страница, на которой произошла приостановка.
Замещение страниц Mark
При загрузке новой страницы в память нужно выделить для неё место. Для этого зачастую требуется что-то выгрузить.
Алгоритм NRU (Not Recently Used)
История похожа на работу с кэшем.
Используем биты статуса страницы в записях таблицы страниц

Алгоритм:
- При запуске процесса M и R для всех страниц процесса обнуляются.
- По таймеру происходит обнуление всех битов R
- При возникновении [[]] страничного прерывания ОС делит все страницы на классы:
- …
Алгоритм FIFO:
- Выбираем самую старую страницу и замещаем, если R = 0.
- Если R = 1, то R обнуляется, обновляется время загрузки страницы в память (т.е. переносится в конец очереди). (Второй шанс быть использованной)
Алгоритм “Часы”:
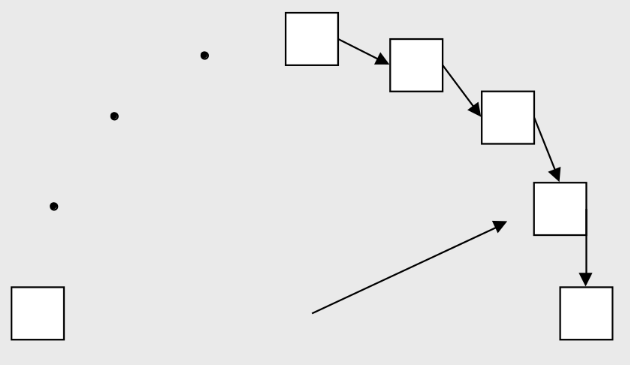
- Если R = 0 - выгрузка страницы и сдвиг на следующую.
- Если R = 1, R обнуляется. Переход на следующий элемент.
Алгоритм NFU (Not Frequently Used):
Заводим счётчик для каждой страницы .
- Изначально для всех .
- По таймеру
Недостатки:
- “Помнит” старую активность
- При большой активности, возможно переполнение счётчика
Модификация:
…