Организация ФС UNIX. Виды файлов.
Файл UNIX - это специальным образом именованный набор данных, размещённый в системе.
Виды файлов:
- Обычный файл (regular file)
- Пользовательские файлы
-
Каталог (directory)
- Специальный файл устройств (special device file)
- С большинством легально зарегистрированных устройств система работает как с файлами.
- Вся информация файла устройства размещается в индексном дескрипторе.
- Именованный канал (FIFO)
- Тот же регулярный, но без возможности перемещения указателя чтения/записи.
- Ссылка (link)
- Файл symlink.
- Сокет (socket)
- Специальный бит файла, позволяющий организовывать взаимодействие процессов.
Права доступа
Категории пользователей:
- Пользователь
- Группа (к которой относится конкретный пользователь)
- Все пользователи системы
Права:
- На чтение
- На запись
- На исполнение
Права на доступ к каталогу:
- Создание и чтение
- Создание и удаление
- Поиск (если есть полное имя, все имена, присутствующие до этого имени должны быть открыты на исполнение, поиск).
Логическая структура каталогов
Очень хотелось разобраться в этом, кстати.
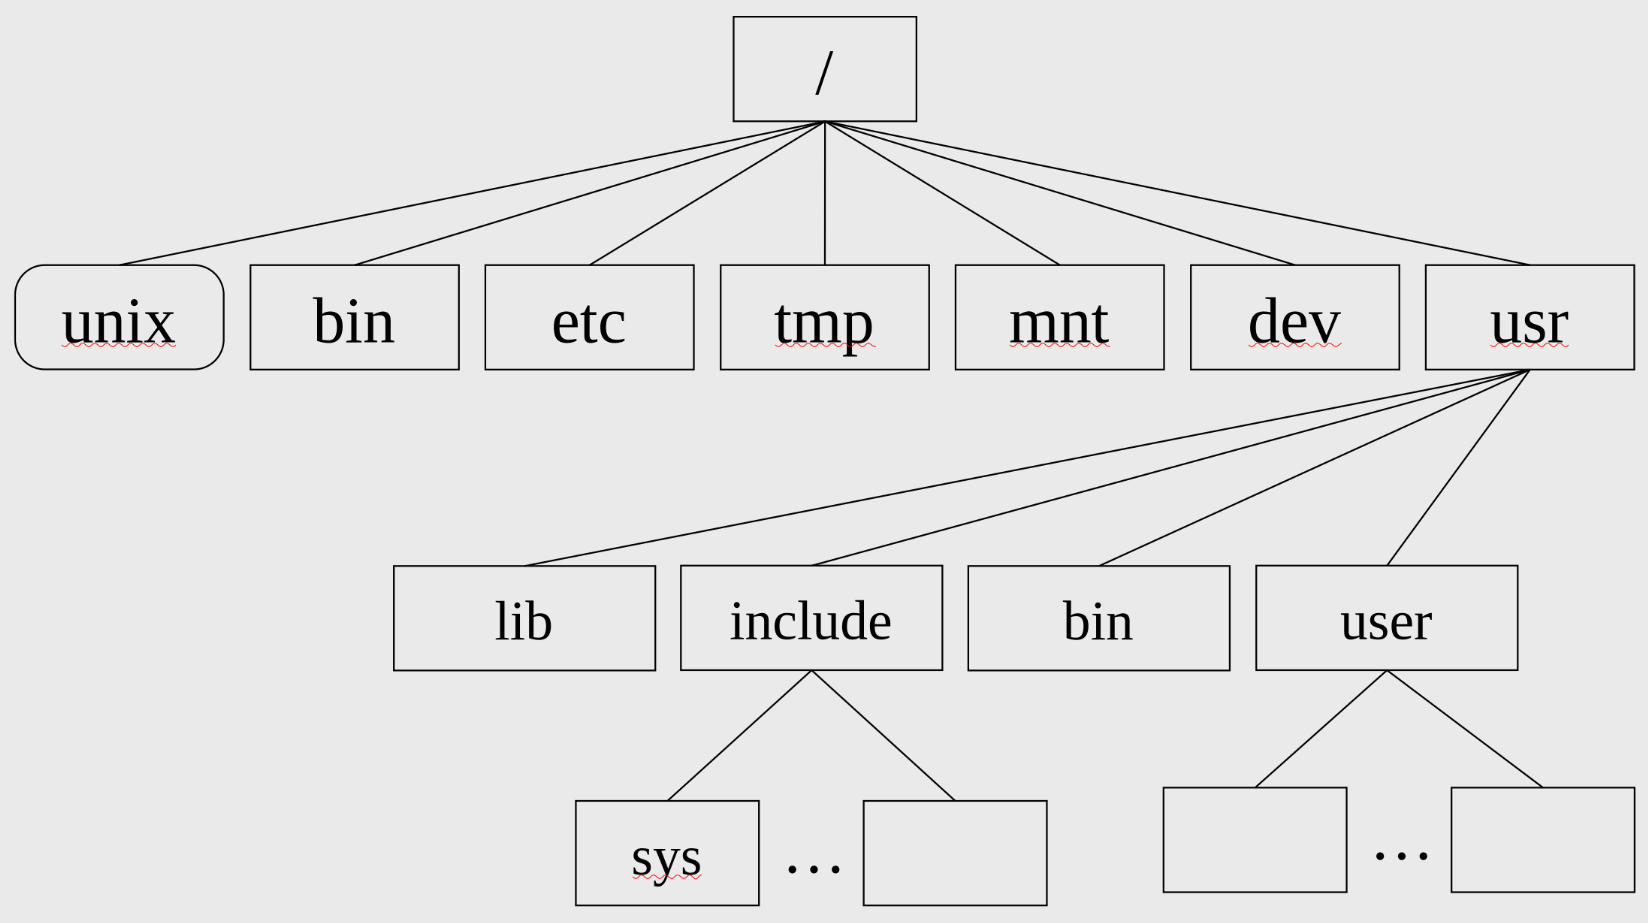
unix- файл, по названию созвучный с названием системы. Система загружается именно этим файлом.bin- каталог с исполняемыми файлами общедоступных команд unix.etc- каталог с исполняемыми файлами и данными, относящимися к системе. (paswd и т.п.)tmp- гарантированное сохраннение содержимого на период работы системы. (временное размещение данных программ и т.п.)mnt- mount. К этому каталогу монтируются (подключаются) внешние файловые системы.dev- каталог устройств, зарегистрированных в системе.usr- пользовательская информация.lib- библиотеки.include- файлы.h(headers).sys- системные заголовочные файлы.
bin- каталог локализованных команд (реализованных на данной установке (конфигурации системы))user- домашние каталоги зарегистрированных пользователей.
Это примерная схема. Она разная от дистрибутива к дистрибутиву.
Интерпретатор команд в ищет команды директориях, указанных в переменной окружения $PATH. Обычно для этого используется hashmap. (также есть приоритетность каталогов для запуска команд). Hashmap формируется при login. Поэтому добавление новой команды “налету” не позволит её запустить интерпретатором.
Модель версии System V
Структура ФС
Суперблок - блок ФС, содержащий настройки ФС и актульное состояние ФС. (размер индексных дескрипторов и размер блоков как раз здесь)
Индексный дескриптор - специальная структура данных ФС, в которой устанавливается взаимооднозначное соответствие с каждым файлом.
Область блоков - блоки файлов находятся в этой области. Системные блоки таже содержатся здесь.
Область индексных дескрипторов - область, в которой содержатся индексные дескрипторы. (размер области индексных дескрипторов/размер индексного дескриптора = предельное количество файлов в ФС).
Структура суперблока
- Тип файловой системы.
- Размер файловой системы в логических блоках, включая сам суперблок, массив индексов дескрипторов (i-node) и блоки хранения данных.
- Размер области индексных десрипторов.
- Число свободных блоков, доступных для размещения.
- Число свободных индексных дескрипторов, доступных для размещения.
- Флаги (флаг модификации, флаг режима монтирования).
- Размер логического блока (512, 1024, 2048…).
- Массив номеров индексных дескрипторов.
- Список номеров свободных блоков.
Работа с массивами номеров свободных блоков
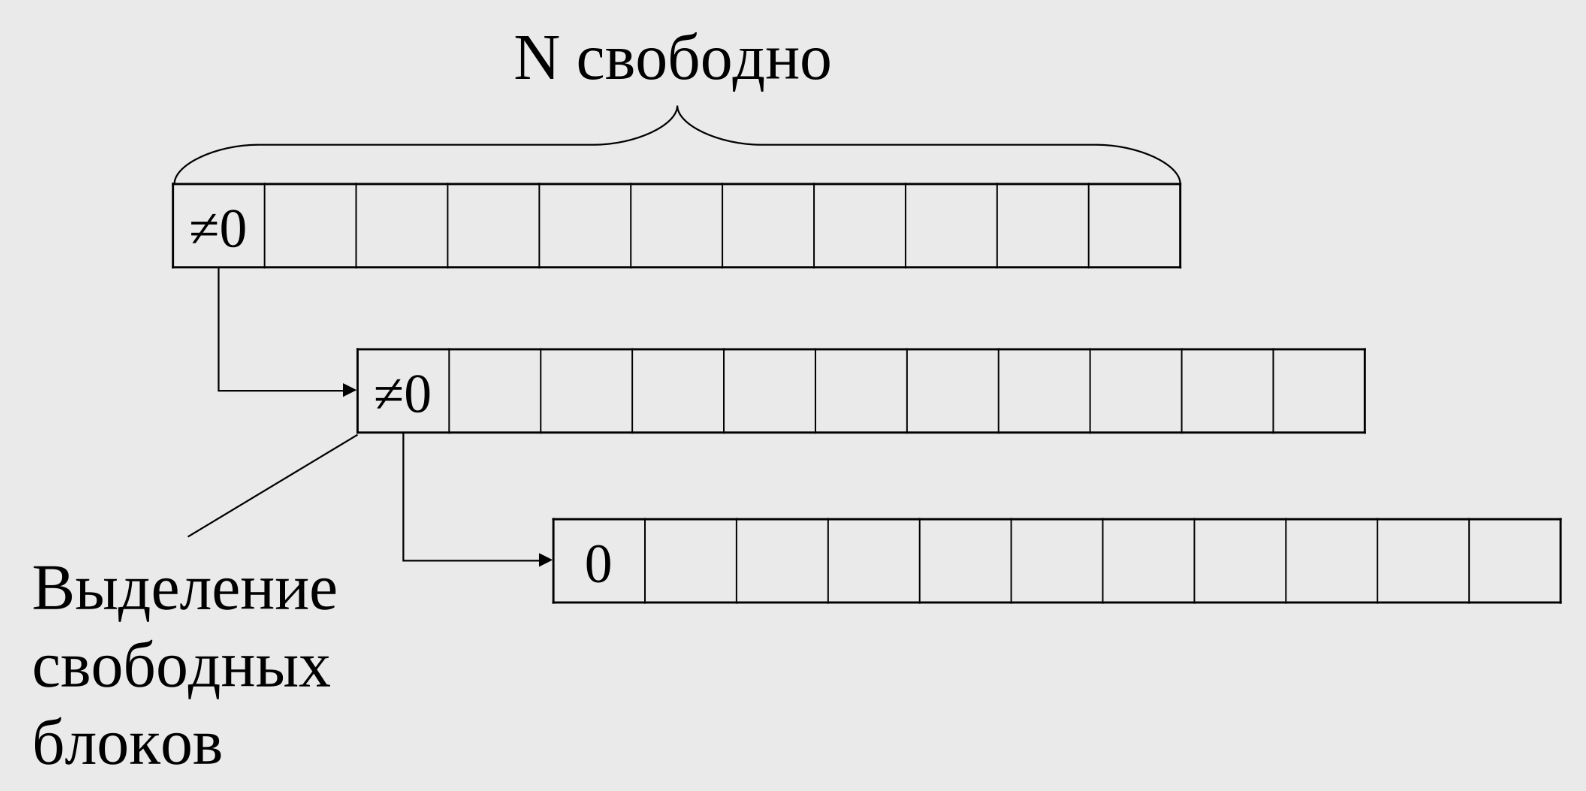
Содержит все свободные блоки системы.
Положение ссылки зависит от реализации.
Работа с массивом свободных индексных дескрипторов
Массив фиксированного размера.
Элемент - номер свободного индексного дескриптора, либо код свободного места в этом массиве.
Когда удаляем файл, смотрим этот массив, ищем в нём пустое место и пешм туда индексный дескриптор, который удалился. Если свободных мест нет, мы забываем о нём.
При создании файла находим в массиве свободный индексный дескриптор.
Структура Индексного дескриптора
- Тип файла
- Права доступа к файлу.
- Количество жёстких ссылок из каталогов. (кличество имён)
- Идентификатор пользователя и группы-владельца.
- Размер файла в байтах.
- Время последнего доступа к файлу.
- Время последнего изменения файла.
- Время последнего изменения индексного дескриптора файла.
- Адресация блоков файлов
Адресация блоков внутри файла
Модельный пример: блок 512b, ссылка на блок 4b.
- суммарный объём занимаемой памяти.
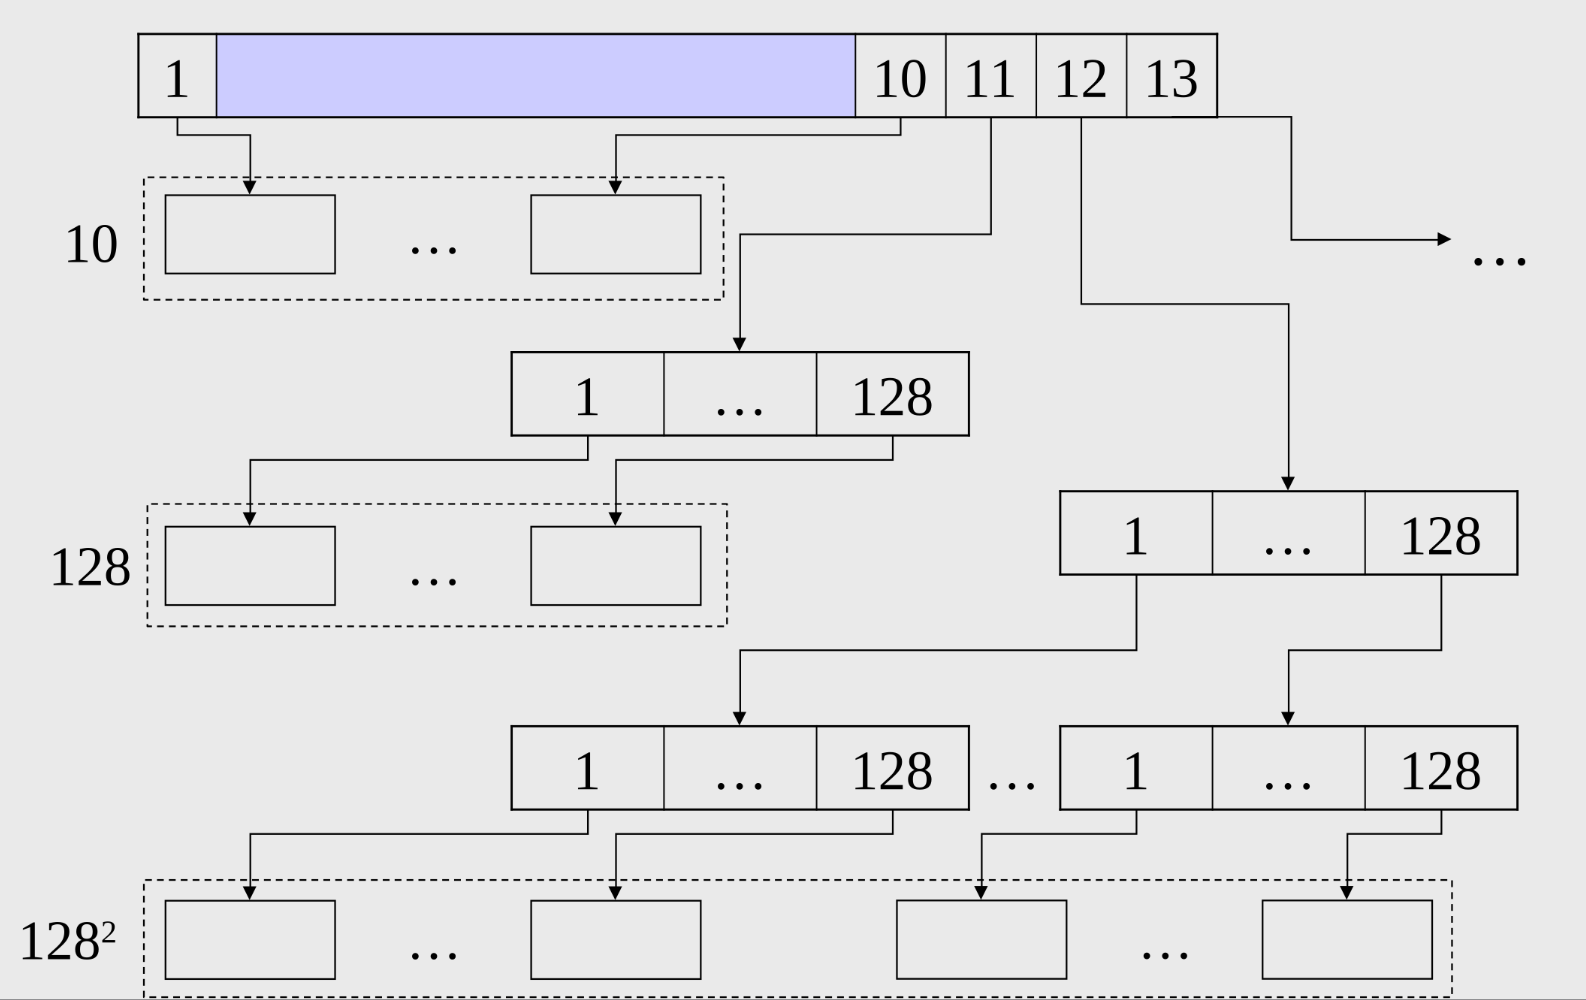
Если нужно прочесть 1-10й блок, накладных расходов нет.
Если нужно прочитать 11й блок, нужно прочесть также служебный блок.
12-й блок имеет косвенность второго порядка.
13-й элемент имеет косвенность третьего порядка.
Это база. Основа последующих файловых систем iOS, Android и т.п.
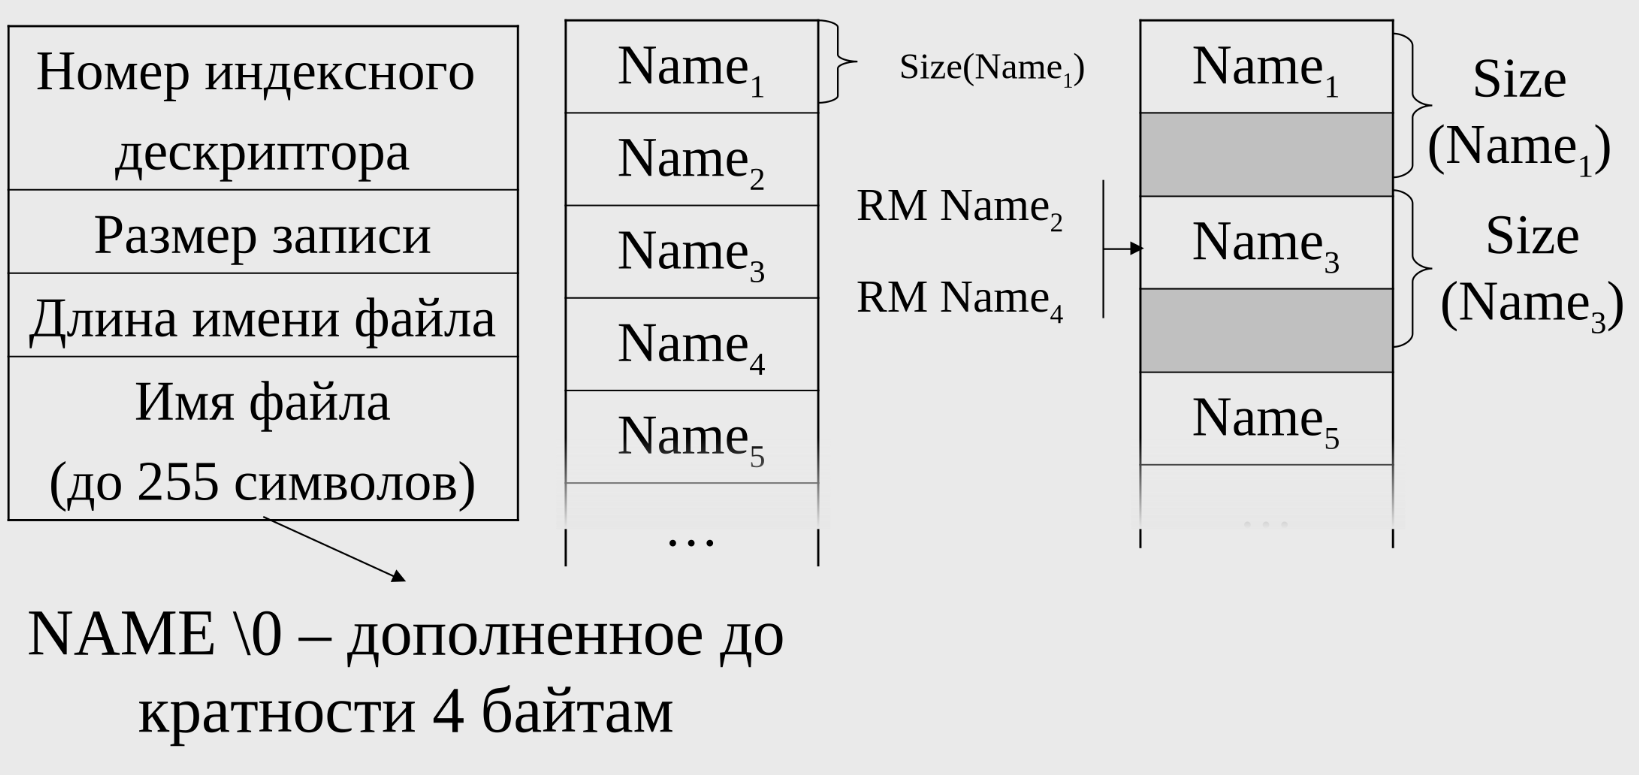
Файл-каталог
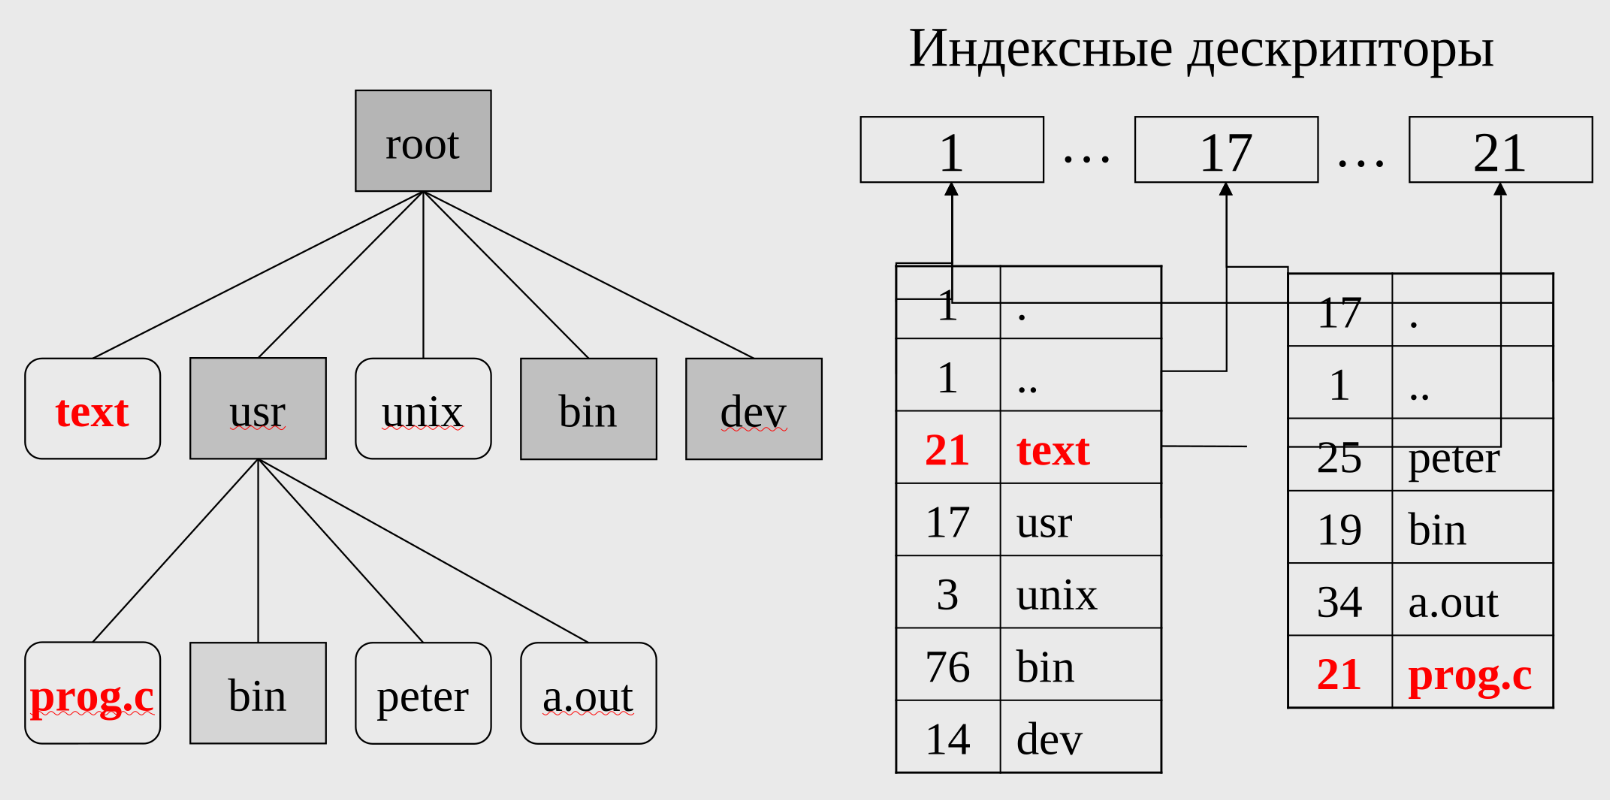
Запись - 16 байтов:
- 2 для номера индексного дескриптора.
- 14 для имени.
. - имя текущего каталога.
.. - имя родительского каталога.
На текущий момент 14 байтов для имени никуда не годится. Это недостаток System V.
Установление связей
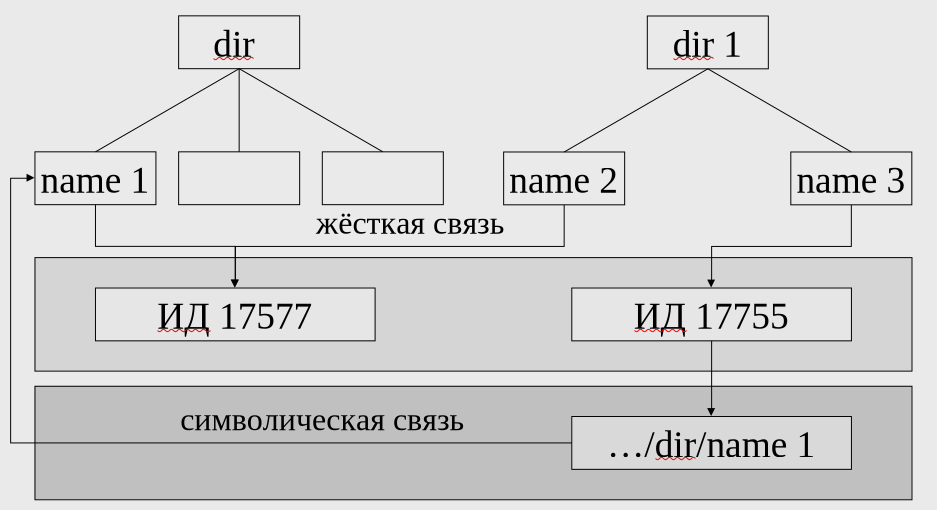
Существуют симлинки. Это файлы, содержащие полный путь к другому файлу. (в примере по name3 мы получаем путь к name1)
При удалении файла удаляется его индексный дескриптор. (содержимое остаётся на диске до того момента, пока его не перезапишут.)
Вывод
Плюсы:
- Оптимизация в работе со списками номеров свободных индексных дескрипторов и блоков.
- Косвенная адресация блоков файлов активно используется и по сей день. (медленно работает с большими файлами, конкретно их частью не помещающейся в первые 10 блоков. Но в остальном - супер)
Недостатки:
- Концентрация важной информации в супрблоке (риск износить диск в этом месте).
- Проблема надёжности. (если умер суперблок, это может закончиться потерями)
- Фрагментация файла по диску (- моторесурс HDD).
- Ограничения на возможную длину имени файла.
Пропал суперблок. Как можно алгоритмически вернуть систему к жизни? Размер блока дан.
- Индексный дескриптор фиксированного размера.
Модель версии FFS BSD
Fast File System
Стратегия размещения
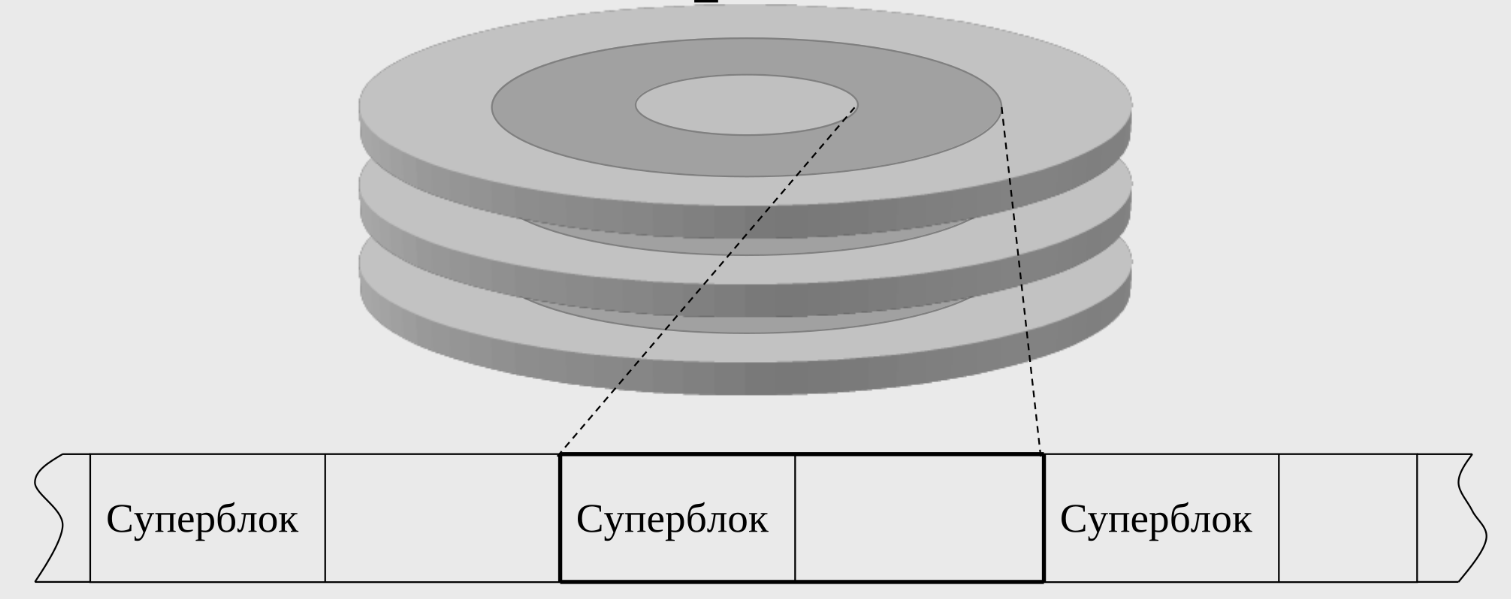
В каждом кластере находится:
- Копия суперблока.
- Информация о свободных блоках (битовый массив в более поздних версиях) и о свободных индексных дескрипторов.
- Массив индексных дескрипторов.
- Блоки файлов.
Размещение каталога:
- Поиск кластеров, имеющих количество свободных индексных дескрипторов, превосходящее среднее значение заполнения (кластеры, в которых можно поместить достаточное количество файлов)
- Среди найденных кластеров выбирается кластер с наименьшим количеством каталогов. В нём создаётся новый каталог.
Равномерность использования блоков данных при размещении файла:
- Первые 10 блоков файла размещаются в том же кластере, где расположен индексный дескриптор, если это возможно.
- Оставшиеся блоки делятся на равные части (подряд идущих блоков) и размещаются в разных кластерах. (это экономит моторесурс устройства памяти)
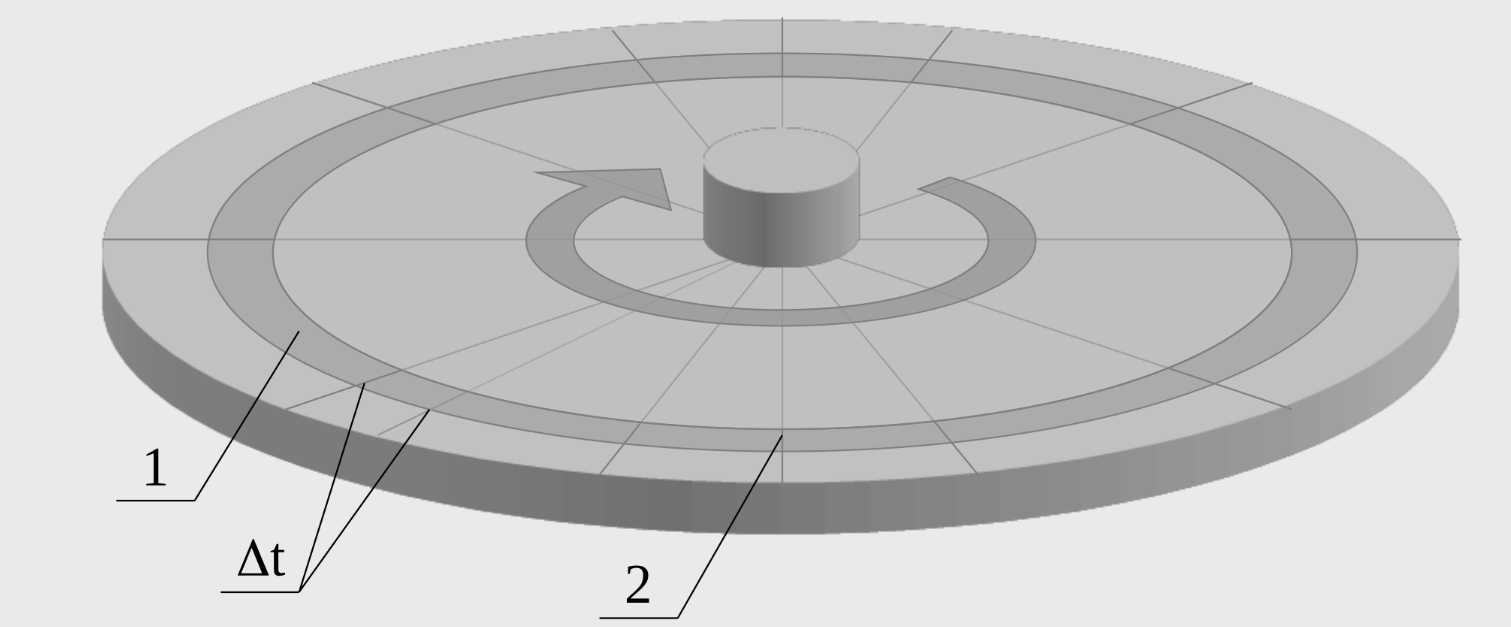
Ситуация выше не очень хорошая: пока мы завершаем обмен по первому блоку, диск уйдёт в другое положение => придётся ждать полного оборота, что очень дорого.
Решается проблема расположением через блок.
Внутренняя организация блоков
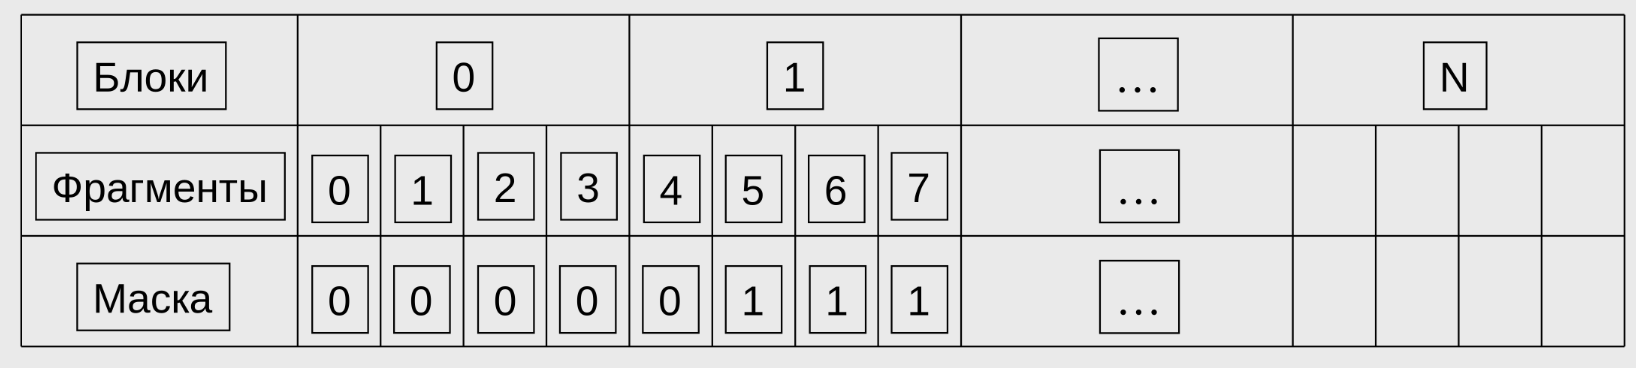
Во избежание фрагментации информации внутри большого блока в FFS добавили фиксированные фрагменты, равные по размеру .
- Все блоки, за исключением последнего, полностью заняты.
- По маске определяем, свободность фрагмента.
Выделение пространства для файла
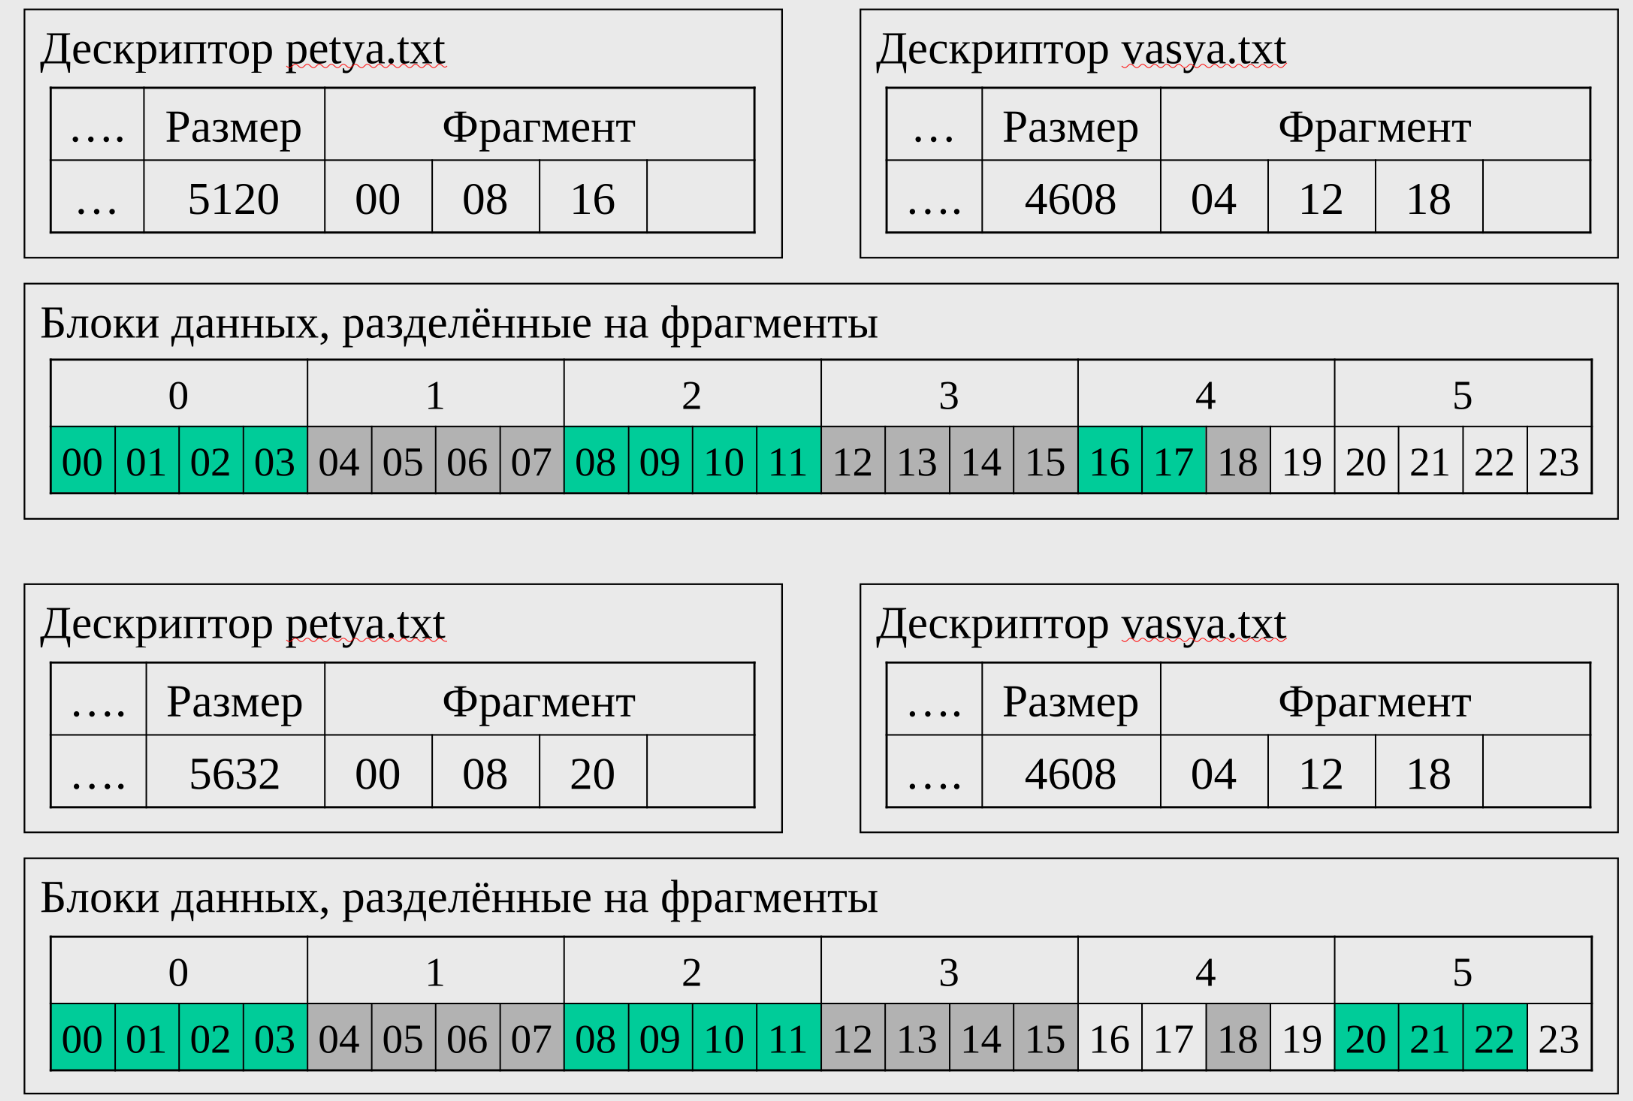
- Числа в полях фрагментов ссылаются на начало этих самых фрагментов.
- В таблице показаны изменения при увеличении файла petya.txt.
- Хвосты нескольих файлов могут храниться в одном фрагменте.
Предопределённые номера индексных дескрипторов
Зарезервированные номера ИД (на примере Ext4 Linux):
0 - несущществующий И. Д.
1 - Список повреждённых блоков.
2 - Корневой каталог.
3 - Квоты пользователей.
4 - Групповые квоты.
…
8 - Журнал.
…
11 - Первый незарезервированный ИД.
Длина имени FFS